鲸鱼娘是好文明!
这篇文章记录了一条完整的链路是怎么打通的:在一块 Rock 5B+(RK3588)开发板上,先把 DeepSeek Harness(DSH)跑起来并接上云端模型,再把本地的 RKLLM 推理服务包成 OpenAI 兼容接口接回 DSH,最终让板载 NPU 上的 DeepSeek-R1-Distill-Qwen-1.5B 直接为 DSH 提供推理,不再消耗云端 token。
整个过程并不顺利。中间经历了模型加载卡死数日的排查、结构体版本对齐、流式连接不关闭、推理模型把 token 预算“想光”等几个典型的坑。这篇文章按实际发生的顺序把它们都写下来,包括走过的弯路,因为这些弯路本身就是结论的一部分。
起点 — 板子够不够跑 DSH
最初的问题很简单:Rock 5B+ 能不能跑 DeepSeek Harness?
查完板子的实际情况,结论是能跑,而且瓶颈不在算力:
- 芯片是 RK3588,8 核 aarch64,NPU 算力 6 TOPS,支持 INT4 / INT8 / INT16 / FP16 等精度
- 内存 16GB,可用约 14GB;系统是 Debian 12,根分区当时还剩约 20GB,负载很低
- DSH 本身只是一个 Node.js Web 应用,不自带模型、不在本地跑推理,真正干活的是它接的模型接口,所以 ARM 架构和内存都不是问题
唯一缺的是 Node。DSH 要求 Node ^22.19.0 或 >=24.0.0(新版本要求 >=24.9.0),而 Debian 12 自带的 Node 18 肯定不够,也不能用 apt 直接装。
当时给出的三条装 Node 的路线是:官方 arm64 包解压即用(不用 sudo、路径固定,最推荐)、用 nvm 装(能多版本切换,但非交互式 SSH 里要先 source 才能找到命令)、NodeSource 走 apt(要动 apt 源,不推荐)。后来发现板子上其实已经装了 nvm,里面有 Node v25.4.0,.bashrc 里也已经写好了加载逻辑,交互式登录时 node -v 直接就能用。这关就这么过了:用现成的 v25.4.0,不再另装。
还有一个前提当时就说清楚了:DSH 默认只绑 127.0.0.1:3080,装完要靠 SSH 隧道从自己的电脑上打开,不能直接暴露到公网。
先用云端 API 把 DSH 跑起来
安装 DSH
决定用当前版本直接装,不折腾降级。安装在板子的工作目录下全局进行:
npm install -g @deepseek-ai/dsh
装的是 0.2.2-rc.1,656 个包约 2 分钟装完。第一次启动时还踩了一个进程管理的坑:用 pkill -f 去停另一个进程时,匹配模式把自己的 SSH 会话也匹配上了,会话刚开就被自己杀掉。之后立下的规矩是按确切 PID 杀进程,不再用 pkill -f <名字> 这种宽匹配。
DSH 的正确后台启动方式是让它脱离终端会话:
export NVM_DIR="$HOME/.nvm"
[ -s "$NVM_DIR/nvm.sh" ] && . "$NVM_DIR/nvm.sh"
setsid dsh web --no-open --host 127.0.0.1 --port 3080 > /home/lyc/dsh.log 2>&1 < /dev/null &
这里有两个细节后来反复用到:一是非交互式 SSH 不会自动加载 .bashrc,必须先手动 source nvm,否则 dsh 命令根本找不到;二是 setsid 让进程开一个新会话,SSH 断开时不会收到挂断信号而跟着死掉。nohup 也能达到类似效果,日常用哪个都可以,setsid 更干净一点。
启动后 curl http://127.0.0.1:3080/ 返回 401 并提示需要认证,说明服务是活的,只是要带 token 才能进。
接 NVIDIA NIM 先跑通对话
DSH 不带模型,第一批模型来自 NVIDIA NIM。在 DSH 里加一个自定义提供方即可:
- Base URL:
https://integrate.api.nvidia.com/v1 - 认证:
Authorization: Bearer <NIM API Key> - 模型从 NIM 的模型列表里选
NIM 的模型列表接口是通的,一共列出 84 个模型,里面有 deepseek-ai/deepseek-v4.1-flash,也有 nvidia/nemotron-3.5-lightning-30b-a3b 等。但实测对话时,DeepSeek Flash 连续两次超时:一次 60 秒、一次放宽到 180 秒都没有返回。列表能通说明 key 和接口没问题,更像是这个模型当时排队太久或不可用。
换成 Nemotron 后 2.7 秒就返回了,但立刻暴露了推理模型的第一个坑:它是推理模型,给 64 个 max_tokens 时,token 全部花在思考过程上,正文是空的;把上限提到 512 后才出正文,其中思考占了 263 个 token。这个经验后面在本地模型上还会以更严重的形式重演一次。结论是:给推理模型配 DSH 时,max_tokens 必须给大。
当时还顺带比较过 NIM 之外的免费接口,结论留在这里供参考:Google Gemini 免费档额度大、OpenAI 兼容,适合做主力备胎;Groq 速度最快但每天 token 上限不高;ModelScope 魔搭国内直连、有 DeepSeek 系列模型,适合在国内网络环境下使用;OpenRouter 的 :free 模型多但每天次数少;DeepSeek 官方的新用户赠送额度只有 30 天有效,不是长期免费档。最终 DSH 里先配了 NIM 和 Gemini 两个 key,日常先用着。
Token 拿不到与桌宠 — 两个绕了很久的支线
DSH 的随机 token
DSH 每次启动都会生成一个随机 token,完整访问链接只打印在启动日志的第一行里,形如 http://127.0.0.1:3080/?token=...。重启一次,token 换一次,旧链接立即失效。
围绕这个 token 前后试了好几条路:
- 固定 token 在原版上行不通。 网上常见的说法是设置环境变量
DSH_WEB_TOKEN或加--token参数。实测下来,原版 DSH 0.2.2-rc.1 根本不认DSH_WEB_TOKEN(在安装包里搜不到这个变量),dsh web --help里也没有--token,只有--host、--port、--no-open、--public-url、--trusted-host和 TLS 相关参数。用自定 token 重启后,它依然随机生成一个新的,自定的那个访问直接返回 401。那个环境变量是第三方插件dsh-remote-access才支持的,不是原版能力。 - 从自动化工具这边读日志会被打码。 日志文件里明明有完整 token,但经过工具输出这一层时,token 值会被自动替换成
<redacted>,复制不出来。grep截取、写进变量再打印,结果都一样。 - 最终跑通的方法是日志上传网盘。 DSH 启动后,把日志文件上传到自己的网盘,在网页端下载下来就能看到完整链接,token 不经过会被打码的那一层。这套方法后来成了固定流程,但有三个细节必须做对:等日志写完再上传(启动后 10 秒就传,曾传上去一个 0 字节的空文件);先确认日志非空且确实包含 token 行再传;文件名每次加时间戳,不要覆盖旧文件,否则网盘缓存或下错文件都会让人误以为 token 失效。用完后应把网盘上的日志文件删掉,毕竟里面就是完整凭证。
用户自己在板子终端里操作则没有这些问题:交互式登录自动加载 nvm,tail 一下日志复制链接,再开一条 SSH 隧道转发 3080 端口,浏览器打开即可。
桌宠 dsh-pet
DSH 装好后还装了一个桌宠插件。名字相近的插件有好几个(女仆类、养鱼类、饲养手册类),最后确认要装的是 dsh-pet 本身,它正是在 DSH 0.2.2-rc.1 下开发测试的版本。
安装过程卡了一步:dsh plugin 背后走的是 pnpm,板上没装 pnpm 时直接报 pnpm was not found。先用 npm 全局装上 pnpm,再执行:
dsh plugin --profile web add dsh-pet
装的是 0.4.5,宠物默认显示在 Web 界面右上角,板子没有桌面环境也不影响,因为它是浏览器里的 overlay。
它有一个背景不透明的问题,社区 issue 331 一度被当作参考,后来确认修不了这个问题:331 讨论的是桌面版(Electron)的穿透、全局热键、托盘等主进程能力,而这里跑的是 Web 版,动画本身是透明的 WebM,背景不透明更可能出在 overlay 容器或视频元素那一层,需要在浏览器里看实际渲染才能定位。这条支线就停在这里,没有继续深挖。
为什么要接本地模型
云端链路跑通后,动机很直接:DSH 做 agent 时来回轮次多,云端 token 消耗快。为了防止 token 烧干,决定把板子本地的蒸馏模型接进来。
这件事的底子其实早就有了。早在 2025 年 6 月,同一块板子上就已经用 RKLLM 跑通过 DeepSeek-R1-Distill-Qwen-1.5B(W8A8 量化、RK3588 版本),当时还专门写过一篇博客记录。关键点是:RKLLM 当时没有官方 Python 接口,所以自己用 ctypes 封装了 librkllmrt.so,把 rkllm_init、rkllm_run(旧称 infer 一类接口)、释放接口等 C 函数绑给 Python 用,封装和运行脚本都留在板子的工作区里。
Radxa 官方文档也印证了这条路线:RK3588 上用 RKLLM 部署这个 1.5B 蒸馏模型,官方实测约 15.36 token/s,日常问答够用;自己转模型必须在 x86 机器上做,板上只能跑预编译好的 .rkllm 文件;文档还明确提醒某个较新版本的 runtime 跑这个 demo 会出现质量退化,所以版本要钉住,不能随便升。
把本地模型接进 DSH,缺的只是中间一层。DSH 支持任何 OpenAI 兼容的服务器,链路是:
DSH -> 自定义模型提供方 -> 本地 OpenAI 兼容接口 (http://127.0.0.1:8080/v1)
    -> RKLLM -> NPU 上的 1.5B 蒸馏模型
中间层的候选当时比较了三个:官方的 RKLLM Flask server demo、社区的 rkllama 一类封装、以及在自己已有的 ctypes 封装外面包一层 HTTP 服务。最后选了第三条,因为它和 2025 年那套已验证过的封装版本完全对得上,不用再做版本对齐。动手前也把三个已知的坑写清楚了:
- DSH 对不认识的模型默认按 100 万 token 上下文计算,而这个
.rkllm的最大上下文是 4096,不手动改一定会超。 - 1.5B 推理蒸馏模型聊天没问题,但做 agent 的工具调用时格式容易跑偏,这是能力边界,先以聊天可用为目标。
- RKLLM runtime、模型文件和 NPU 驱动的版本必须严格对应,这是这类部署最常见的失败原因。
第一版服务搭起来,却卡在加载那一行
第一版服务很快就写好了。板上没有装 Flask,所以服务用 Python 标准库的 http.server 实现,零额外依赖,原有的 wrapper 和运行脚本不动,只在外面包一层:
GET /v1/models:列出唯一的模型POST /v1/chat/completions:非流式和 SSE 流式都支持GET /health:探活- 启动时初始化一次模型,全局锁串行推理;每个请求不保留历史并清 KV 缓存,保证 DSH 的多个会话互不串话;prompt 按 ChatML 格式拼接;回复里的思考段从正文剥离,单独放进
reasoning_content
服务能部署、能启动,日志也证实运行环境是对的:runtime 1.2.1b1、rknpu 驱动 0.9.8、平台 RK3588、最大上下文 4096、NPU 3 核。但之后就再也没有下文了:等了几分钟,/v1/models 始终不通,日志停在这一行就不再动:
I rkllm: rkllm-toolkit version: 1.2.1b1, max_context_limit: 4096, npu_core_num: 3, target_platform: RK3588
直接在板上跑官方的命令行 demo,症状一模一样:卡在同一行死掉,和 SSH、和 Python 层都没有关系。对比文档里成功运行的日志,差别非常明确:成功时这行之后紧接着会出现 Enabled cpus: [4, 5, 6, 7]、系统提示词、prompt 前后缀,最后是 rkllm init success,整个初始化只要约 1.4 秒。而卡住的这次,Enabled cpus 那一行始终没有出现。也就是说,卡点在 rkllm_init 加载模型这一步的内部,在打印完 toolkit 信息之后、绑定 CPU 核之前。
排查卡死 — 把驱动、runtime、模型一个个排除
接下来几天基本都在排查这一步。思路是逐个排除变量,每次只换一个。
驱动:排除
在板上直接查了驱动状态:
sudo cat /sys/module/rknpu/version
sudo cat /sys/kernel/debug/rknpu/version
sudo dmesg | grep rknpu
结果一致:驱动版本 0.9.8,开机约 17 秒时就完成初始化,IOMMU 已启用,之后没有任何报错。lsmod 里看不到 rknpu 是正常的,因为这个驱动是编进内核的,不是可加载模块。另外也核对了版本对应关系:runtime 1.2.1b1 要求驱动 0.9.7 以上、最好是 0.9.8,板子正好是 0.9.8,版本数字上是对得上的。如果真是驱动太低,runtime 通常会直接警告驱动版本不足,而不是一声不吭地卡死。所以驱动先排除。
Runtime 版本:排除
先后换了两版较新的 runtime 库来跑同一个 demo:
- 1.2.2 第一次下载时文件没下全,只有 272KB(正确大小应为 7,486,400 字节),跑起来直接 Bus error。这次不算数,也留下一个教训:换库之前先核对文件大小,最好再验哈希。
- 1.2.2 完整文件换上后,日志正确打印出 runtime 1.2.2,依然停在 toolkit 那一行。
- 1.2.3 同样下全并确认被优先加载,日志打印 runtime 1.2.3,依然卡在同一行,180 秒后被 timeout 杀掉,退出码 124。
三个 runtime 版本卡在同一行,说明问题不在 runtime 版本本身。
模型文件:基本排除
换了一个完全不同的模型做对照:Qwen2-VL-2B(带视觉模型的 RKLLM 模型)。第一次运行因为非交互式 SSH 没带 LD_LIBRARY_PATH,直接报找不到库而退出,不算有效测试;按 demo 自己的用法带齐库路径、图片、视觉模型和语言模型重跑之后,它同样停在同一行:runtime 和 toolkit 信息打印完,Enabled cpus 不出现,180 秒超时。
两个不同模型、三个 runtime 版本、同一个卡点,结论收窄为:这不是某个模型文件独有的问题,也不像是单纯的版本不匹配。剩下最可疑的是手里这套 demo 本身——它是 2025 年 6 月、基于 1.2.1b1 时期的旧二进制。另一个对照现象也支持“现象并不统一”:曾有一个用更新工具链转的 0.8B 小模型不是卡死,而是快速报初始化失败,说明不同模型加不同 demo 的失败方式并不一样,不能一概而论。
交叉编译这条路:被网络堵死
既然怀疑 demo 太旧,自然的下一步是重编一个新 demo。x86 的 4090 服务器可以做交叉编译:克隆新版 rknn-llm 源码、用 gcc-arm-10.2 的 aarch64 工具链编译。机器本身没问题,编译器、CMake、磁盘都够,但它出站到外网的路基本是封的:GitHub、Google、Codeberg、Hugging Face 镜像都连不上,表现一致——DNS 能解析,TLS 握手直接失败或无响应。所以源码和工具链都下不下来,交叉编译没法开始,只能等别人从能上网的机器上下好再中转。
期间的两个插曲:模型库调查和板子离线
排查期间还顺带摸清了两个模型来源,后来都派上了用场:
- ModelScope 上官方账号有一整套 RK3588 模型,但要注意:其中 Qwen3-0.6B 那个仓库里只有模型文件本身(约 931MB)、配置和说明,没有 runtime 库、没有 demo;它的配置写的是 RKLLM v1.2.4、上下文只有 1024。光下模型跑不起来,配套 runtime 必须另外从 rknn-llm 的对应 release 里拿。
- 一个联想网盘里存着官方的
rkllm_model_zoo,按 RKLLM 版本分目录。其中 1.3.0 目录最完整,模型、Quickstart 的 Linux demo 和库是一套的(例如 RK3588 的 Qwen3.5-0.8B 语言模型约 1.2GB、视觉模型约 209MB,demo 和两个运行库都在);1.3.1 是空目录;更早的目录里分别是视觉模型、纯文本模型等;1.1.4 里也有一个同名 DeepSeek 1.5B 模型,但大小约 1.9GB,和手里那个 2.0GB 的并不是同一个文件。网盘页面是 JavaScript 渲染的,板子上用curl抓分享页拿不到文件,必须先拿到每个文件的直链才能在板上直下,这条路当时没有走完就先停下了。
同一段时间里板子还离线过一阵:远程和本地都连不上,IP 还在两个地址之间跳变;远程 SSH 又受出口代理的连接重置影响,频繁重试只会拉长限制,于是定下了每 10 分钟最多连一次、每次把所有事批量做完的纪律。这些都让排查进度比预期慢,但没有改变排查结论。
转机 — 魔搭成套的 1.2.2 模型包跑通了
转机来自换一个“成套”的来源。不再混搭手里的旧模型、旧 demo 和新 runtime,而是从 ModelScope 上用 git 下载 radxa 发布的 DeepSeek-R1-Distill-Qwen-1.5B RKLLM 仓库,它本身就是一套配好的东西:
- 模型文件约 2.05GB(W8A8、RK3588)
demo_Linux_aarch64/llm_demo可执行文件- 它自带的
lib/librkllmrt.so(约 7.49MB),仓库里只有这一个运行库 - 最新提交信息写的是 rkllm-1.2.2,即模型、runtime、demo 同为 1.2.2 这一代
- README 给的运行方式是设置
LD_LIBRARY_PATH指向它自带的lib/、打开RKLLM_LOG_LEVEL=1看详细日志,再运行 demo;标称性能为 RK3588 上 15.36 token/s
下载时还遇到了一个虚惊:git lfs pull 报错,说模型文件无法加入 git 索引。检查后确认这只是 git 2.39 与 git-lfs 3.3 的索引兼容问题,文件本身已经完整下下来了。验证方法是硬核的:模型文件 2,049,333,260 字节、运行库 7,486,400 字节,两者的 SHA256 都和 git-lfs 记录的对象 ID 完全一致。文件没问题,报错可以不管。
然后用这套自带的 demo 和库,在原来的文件夹里跑了一次,结果一次通过:
- 日志出现
rkllm init success和Enabled cpus: [4, 5, 6, 7] - 初始化只用了约 1960 毫秒,峰值内存约 1.73GB
- 生成速度约 15.7 token/s,和 README 标称的 15.36 基本对得上
- 最后的退出码 124 是 180 秒超时杀掉进程造成的,不是卡死:那次运行把标准输入接到了空设备,demo 拿不到输入,就对着空问题反复生成同一句话,循环到超时为止
至此根因定下来了:之前卡死的锅在那套 2025 年 6 月的旧 demo(二进制基于 1.2.1b1),模型文件和 NPU 驱动都没有问题。把模型、demo、runtime 作为一套同版本的东西使用,是这类部署最重要的一条经验。
按 1.2.2 头文件修 Python 封装,服务真正可用
命令行 demo 跑通后,回到 Python 服务。把服务指向 1.2.2 的运行库、在 conda 的 rknn 虚拟环境里启动(按要求,服务要跑在虚拟环境而不是系统 Python 里),出现了新问题:服务能起来,/v1/models 正常,但一调用 /v1/chat/completions 就立刻返回 rkllm_run returned -1,0.1 秒就失败,连推理都没开始。
这次的定位线索来自两个参考:自己 2025 年博客里贴出的旧版头文件,以及官方仓库当前的 rkllm.h 和官方 server demo 里的 Python 实现。对照后发现,1.2.2 的结构体布局已经变了,而旧封装还在按旧布局传参:
RKLLMInput在input_type之前多了role和enable_thinking两个字段,联合体的偏移整体变了。旧布局传进去的 prompt 指针位置是错的,runtime 读到的是垃圾数据,于是直接返回 -1。这正是“结合 runtime 版本修改头文件绑定”这件事的实际含义。RKLLMExtendParam多了n_batch和use_cross_attn字段。RKLLMResult末尾多了性能统计字段。- 回调函数在 1.2.2 里要求返回整数;清 KV 缓存的接口也变成了 4 个参数的新签名。
按新布局把这几处都改掉(原文件都留了备份),服务里给输入设置好角色并关闭额外的思考开关,再重启服务,中文实测一次通过:鸡兔同笼问题答对了(鸡 9 只、兔 5 只),思考过程被单独放进 reasoning_content,正文只有答案,一次 316 个 token 用了约 30 秒,符合这个模型的速度量级。
接入 DSH — 本地模型第一次在界面里对话
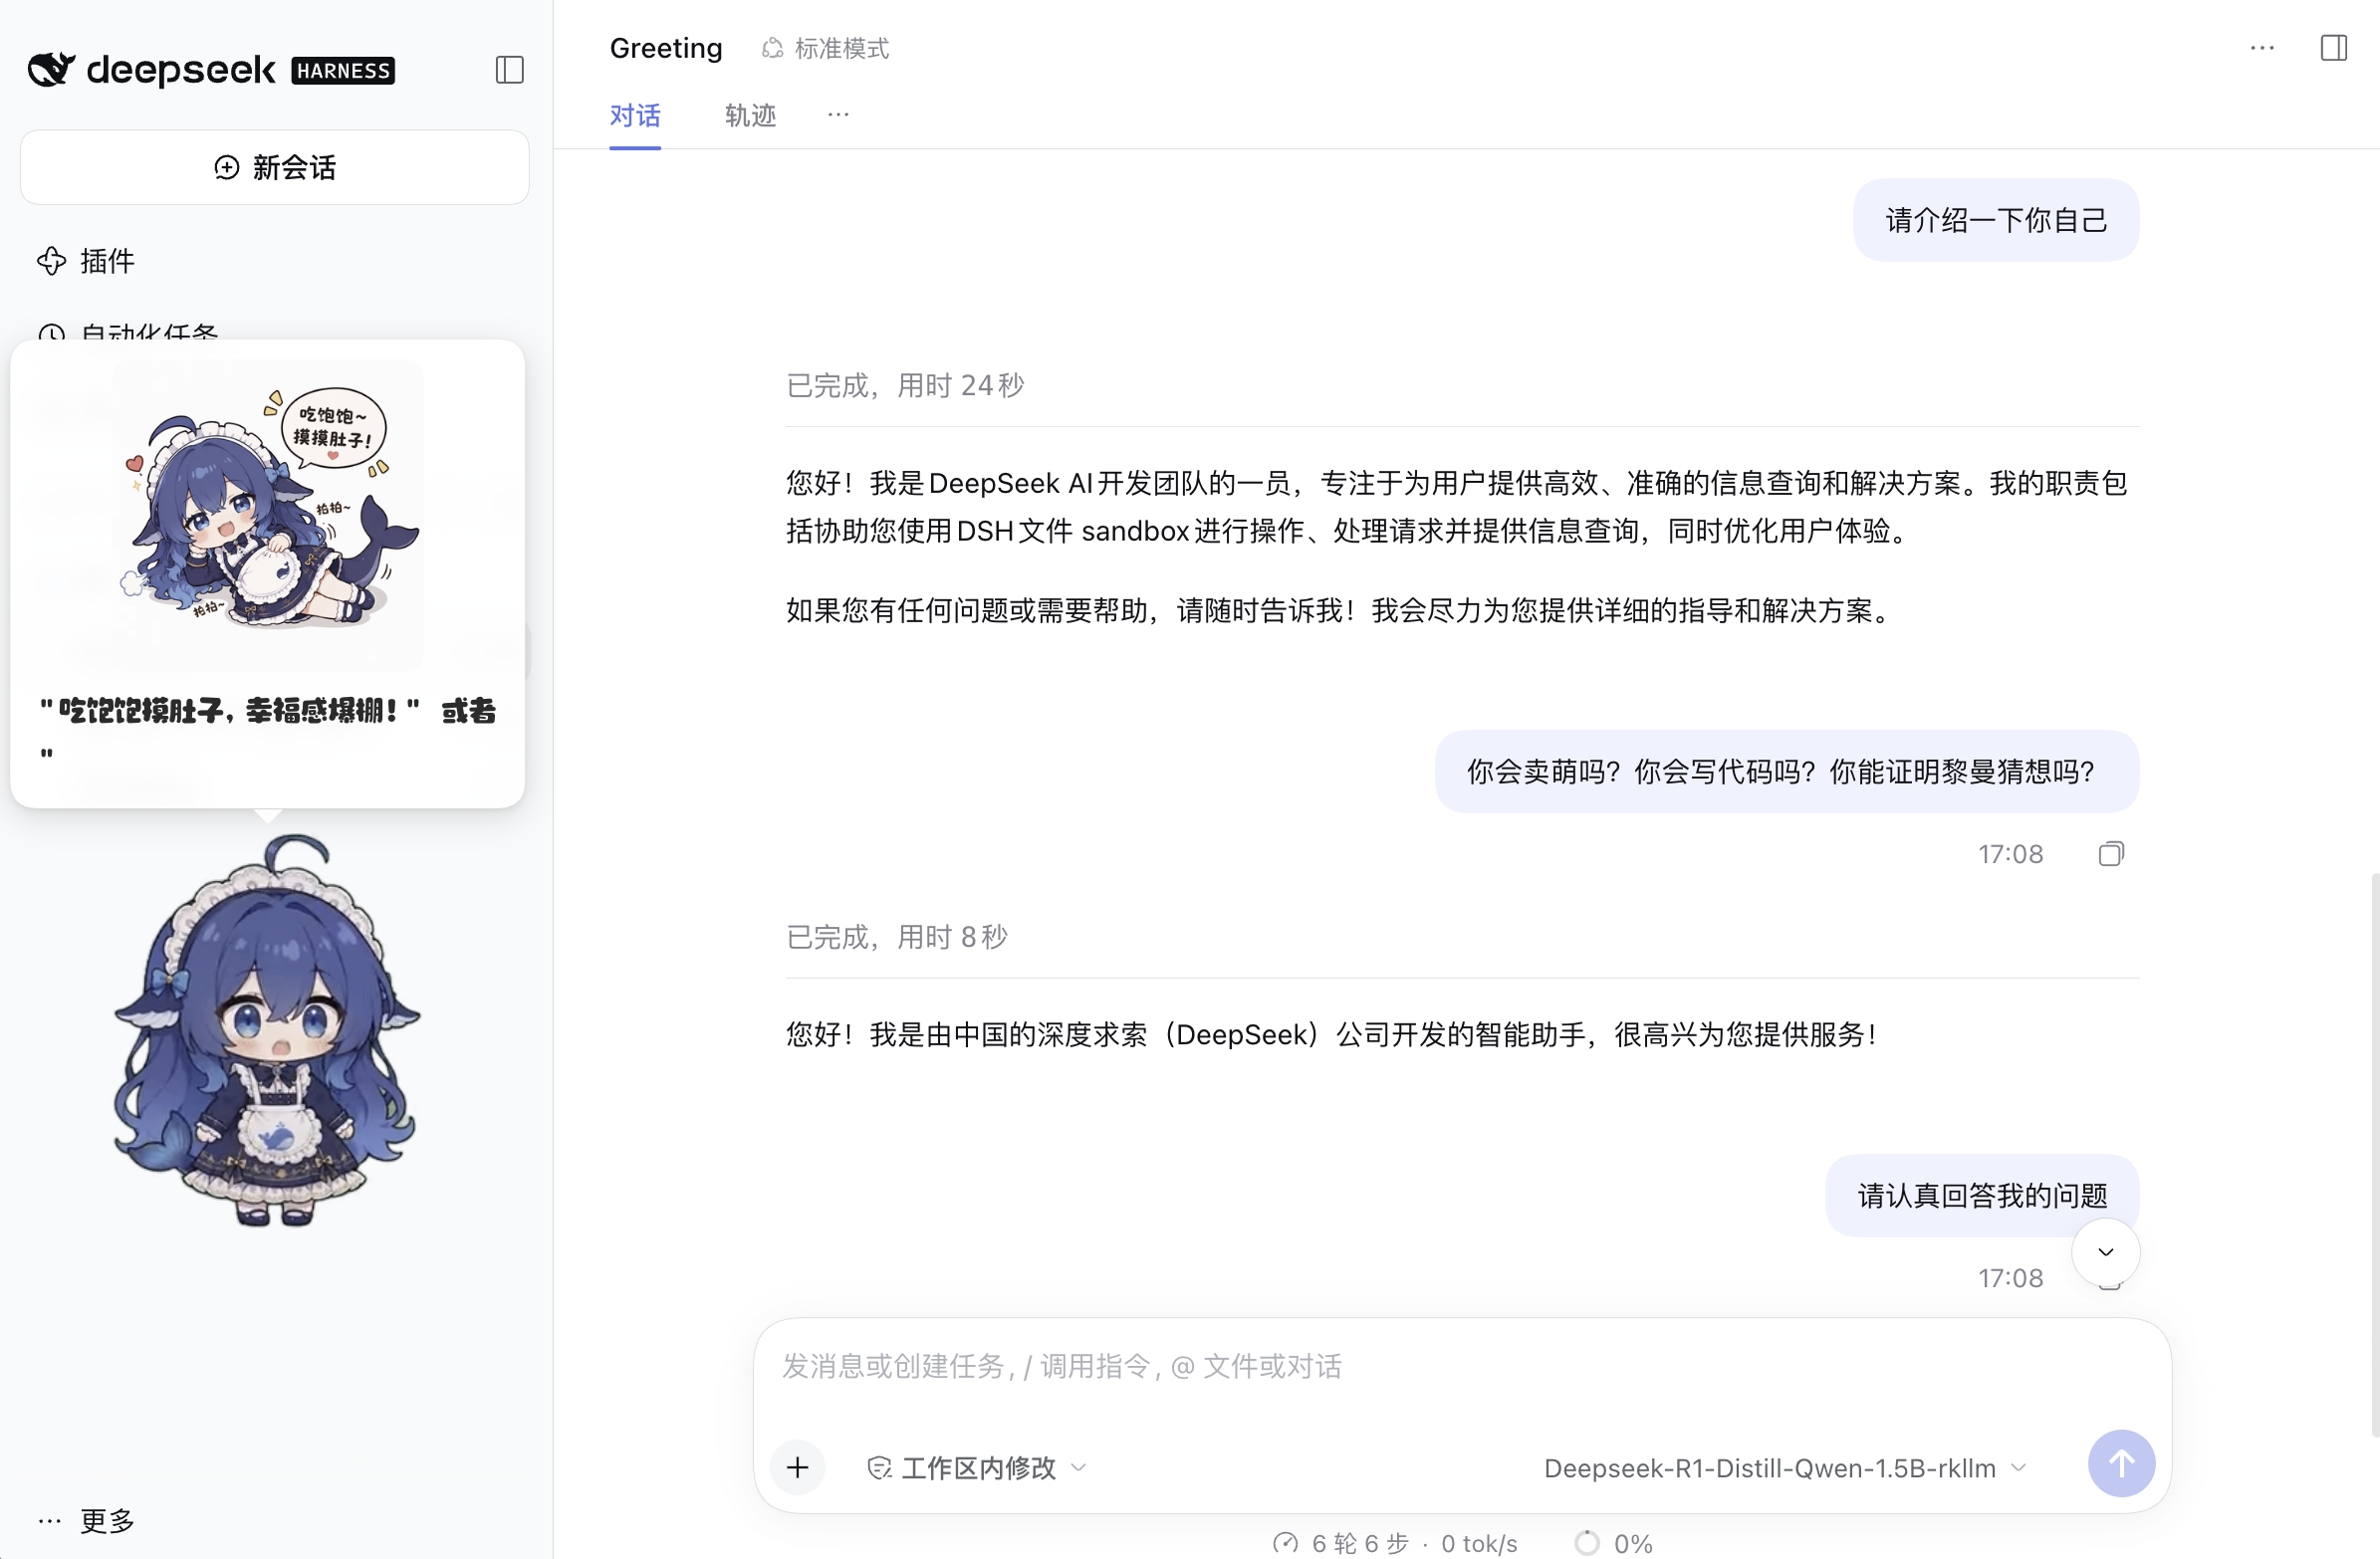
服务跑通后启动 DSH,并按前面摸索出的流程把带 token 的日志上传到网盘取回链接。然后在 DSH 里加本地提供方,第一次运行报了一个错:no API Key for provider: localllm。
这个错和服务端无关:当时服务端根本不校验 key,但 DSH 要求自定义提供方的 API Key 字段不能为空。填一个占位值(例如 local)保存后,再试就成功了。整条链路至此打通:
DSH (127.0.0.1:3080) -> localllm 提供方 -> rkllm_server (127.0.0.1:8080/v1)
    -> RKLLM 1.2.2 -> RK3588 NPU 上的 DeepSeek-R1-Distill-Qwen-1.5B
DSH 里这套本地模型的完整配置是:
- Provider:
localllm - Base URL:
http://127.0.0.1:8080/v1 - API Key:
local(先是占位,后来服务端真的加了验证,这个值就成了真 key,两边必须一致) - 模型名:
deepseek-r1-distill-qwen-1.5b-rkllm - 上下文:手动改成 4096(DSH 默认按 1M 计算,不改必错)
另外要注意,温度和最大生成 token 在当时是服务端初始化时定死的,DSH 界面里改这两个值并不生效,这是 RKLLM 接口形态决定的。
补上 API Key 验证和自动化测试
链路通了之后,下一步原本考虑的是多模型切换,同时明确要求:先给接口加上 API Key 验证,并写一个 API 验证脚本,切换方案后面再定。
先看官方 demo 对切换的支持
参考的官方 rkllm_server_demo 本身没有运行时切换模型的能力:它在启动时用参数定死一个模型,/v1/models 只列这一个,请求里带的模型名只是原样回显,推理用的永远是启动时那个。它提供的只有切换的原语:释放接口本质上就是销毁句柄,再重新初始化一个新的。
所以可行的切换方案只有两条,当时没有急着定:
- 多进程,一模型一端口。 每个模型开一个服务进程,换模型就是在 DSH 里换 Base URL。零停机、最稳,代价是每个进程占一份内存(1.5B 约 1.7GB、0.8B 约 1GB,16GB 内存放三四个小模型没问题)。
- 单进程,接口切换。 服务内加一个切换接口,加锁后先初始化新模型再销毁旧模型。只占一份内存,但切换时有约 2 秒停顿,还要处理失败回滚。
API Key 验证
给服务加上了真正的验证机制:
- 所有
/v1/*接口都要求Authorization: Bearer <key> - key 由服务端环境变量
RKLLM_API_KEY配置,默认值与 DSH 里填的占位值保持一致;要换 key,两边一起换 /health不要求 key,方便监控直接探活- 无 key 或错 key 返回 401,未知模型名返回 404
验证脚本:14 项全过,还抓出一个真 bug
验证脚本只用 Python 标准库,不依赖任何第三方包,放在服务旁边随时可以重跑。它覆盖 14 项:health 探活、模型列表在无 key / 错 key / 对 key 三种情况下的表现、对话在三种 key 情况下的表现、流式对话、缺字段、错误 JSON、空消息列表、未知模型、未知路径,以及两路并发对话。
第一次跑是 13/14,流式那项失败了,而且失败方式很典型:等了 185 秒超时,一个数据块都没收到。根因不在模型,而在 HTTP 层:服务端发出 SSE 的结束标记 [DONE] 后,仍保持着 HTTP/1.1 的长连接不关闭,而用标准库读取响应的客户端要等连接关闭(读到 EOF)才肯返回,于是就一直等下去。修复方法是在流式结束时明确发出 Connection: close 并主动关闭连接。修后重跑,流式 5.6 秒返回 5 个数据块,14 项全部通过。
这个 bug 也说明了验证脚本的价值:如果只在 DSH 界面里点一下能对话就收工,这种“能用但不关连接”的问题会一直潜伏在那里。
空回复 bug — 推理模型把 token 预算想光了
接入后不久,DSH 里出现了一次报错:model returned a completed response with no content,看起来像模型挂了。检查后服务端其实活得好好的,已经连续运行了近 50 分钟,health 也正常。
根因还是推理模型的 token 预算问题,而且和前面 NIM 上 Nemotron 的那次是同一个坑的放大版:DeepSeek-R1 这类模型要先输出一大段思考过程,再写正文。当时服务端的 max_new_tokens 只有 512,遇到难题时,光思考就把 512 个 token 耗尽,正文一个字都没来得及写;服务端再把思考段从正文里剥掉,剩下的正文自然就是空的,DSH 就报了“完成但无内容”。
修了两处:
- 把
max_new_tokens从 512 提到 2048,让模型想完之后还有预算写正文。 - 加兜底逻辑:如果正文最终还是空的,就把思考过程作为正文返回,保证客户端永远不会收到一个空回复;流式路径同样处理。
验证用了一道证明题(证明根号 2 是无理数),约 42 秒返回了完整答案。这个坑的通用教训是:给推理模型设生成上限时,预算必须按“思考加正文”一起算,只按答案长度估算一定会翻车。
推理等级 — 让 low / medium / high 真正生效
最后一个功能是推理等级。DSH 里其他内置模型都有 Effort(推理强度)菜单,但这个自定义模型一开始没有。原因不在服务端:DSH 不会从 /v1/models 的返回里读取推理等级,内置模型的等级信息来自它自带的模型目录,而手动添加的模型默认没有声明,所以菜单不出现。打开方式是在 DSH 的设置里手动声明:
Settings -> Models -> 打开 localllm 提供方 -> Customized settings
-> 对应模型的 Model options -> 打开 Reasoning levels
里面默认有 off / low / medium / high 四档,每档的 API value 就是请求里 reasoning_effort 字段的值。声明并保存、新开会话后,模型选择器里就会出现 Effort 菜单。
但只打开菜单还不够:DSH 把 reasoning_effort 发过来后,服务端起初是忽略它的,因为 RKLLM 的 max_new_tokens 只能在初始化时设定。后来按确定的档位把它真正实现了:
| 推理等级 | 最大生成 token |
|---|---|
| low | 512 |
| medium | 1024 |
| high | 2048 |
服务端的处理方式是:收到请求时把 reasoning_effort 换算成对应的 token 预算;档位没变就不做任何事;档位变了才重新加载一次模型,约需 2 秒,并且是先把新模型建好、再换掉旧的,万一新模型加载失败,旧模型继续保留,服务不会因此挂掉。当前档位和 token 预算也能从 /health 里直接看到,方便核对。
验证脚本随之扩到 17 项,新增了三档切换的检查,结果 17/17 全过:依次请求 low、medium、high,接口都返回 200,health 里显示的预算分别是 512、1024、2048。
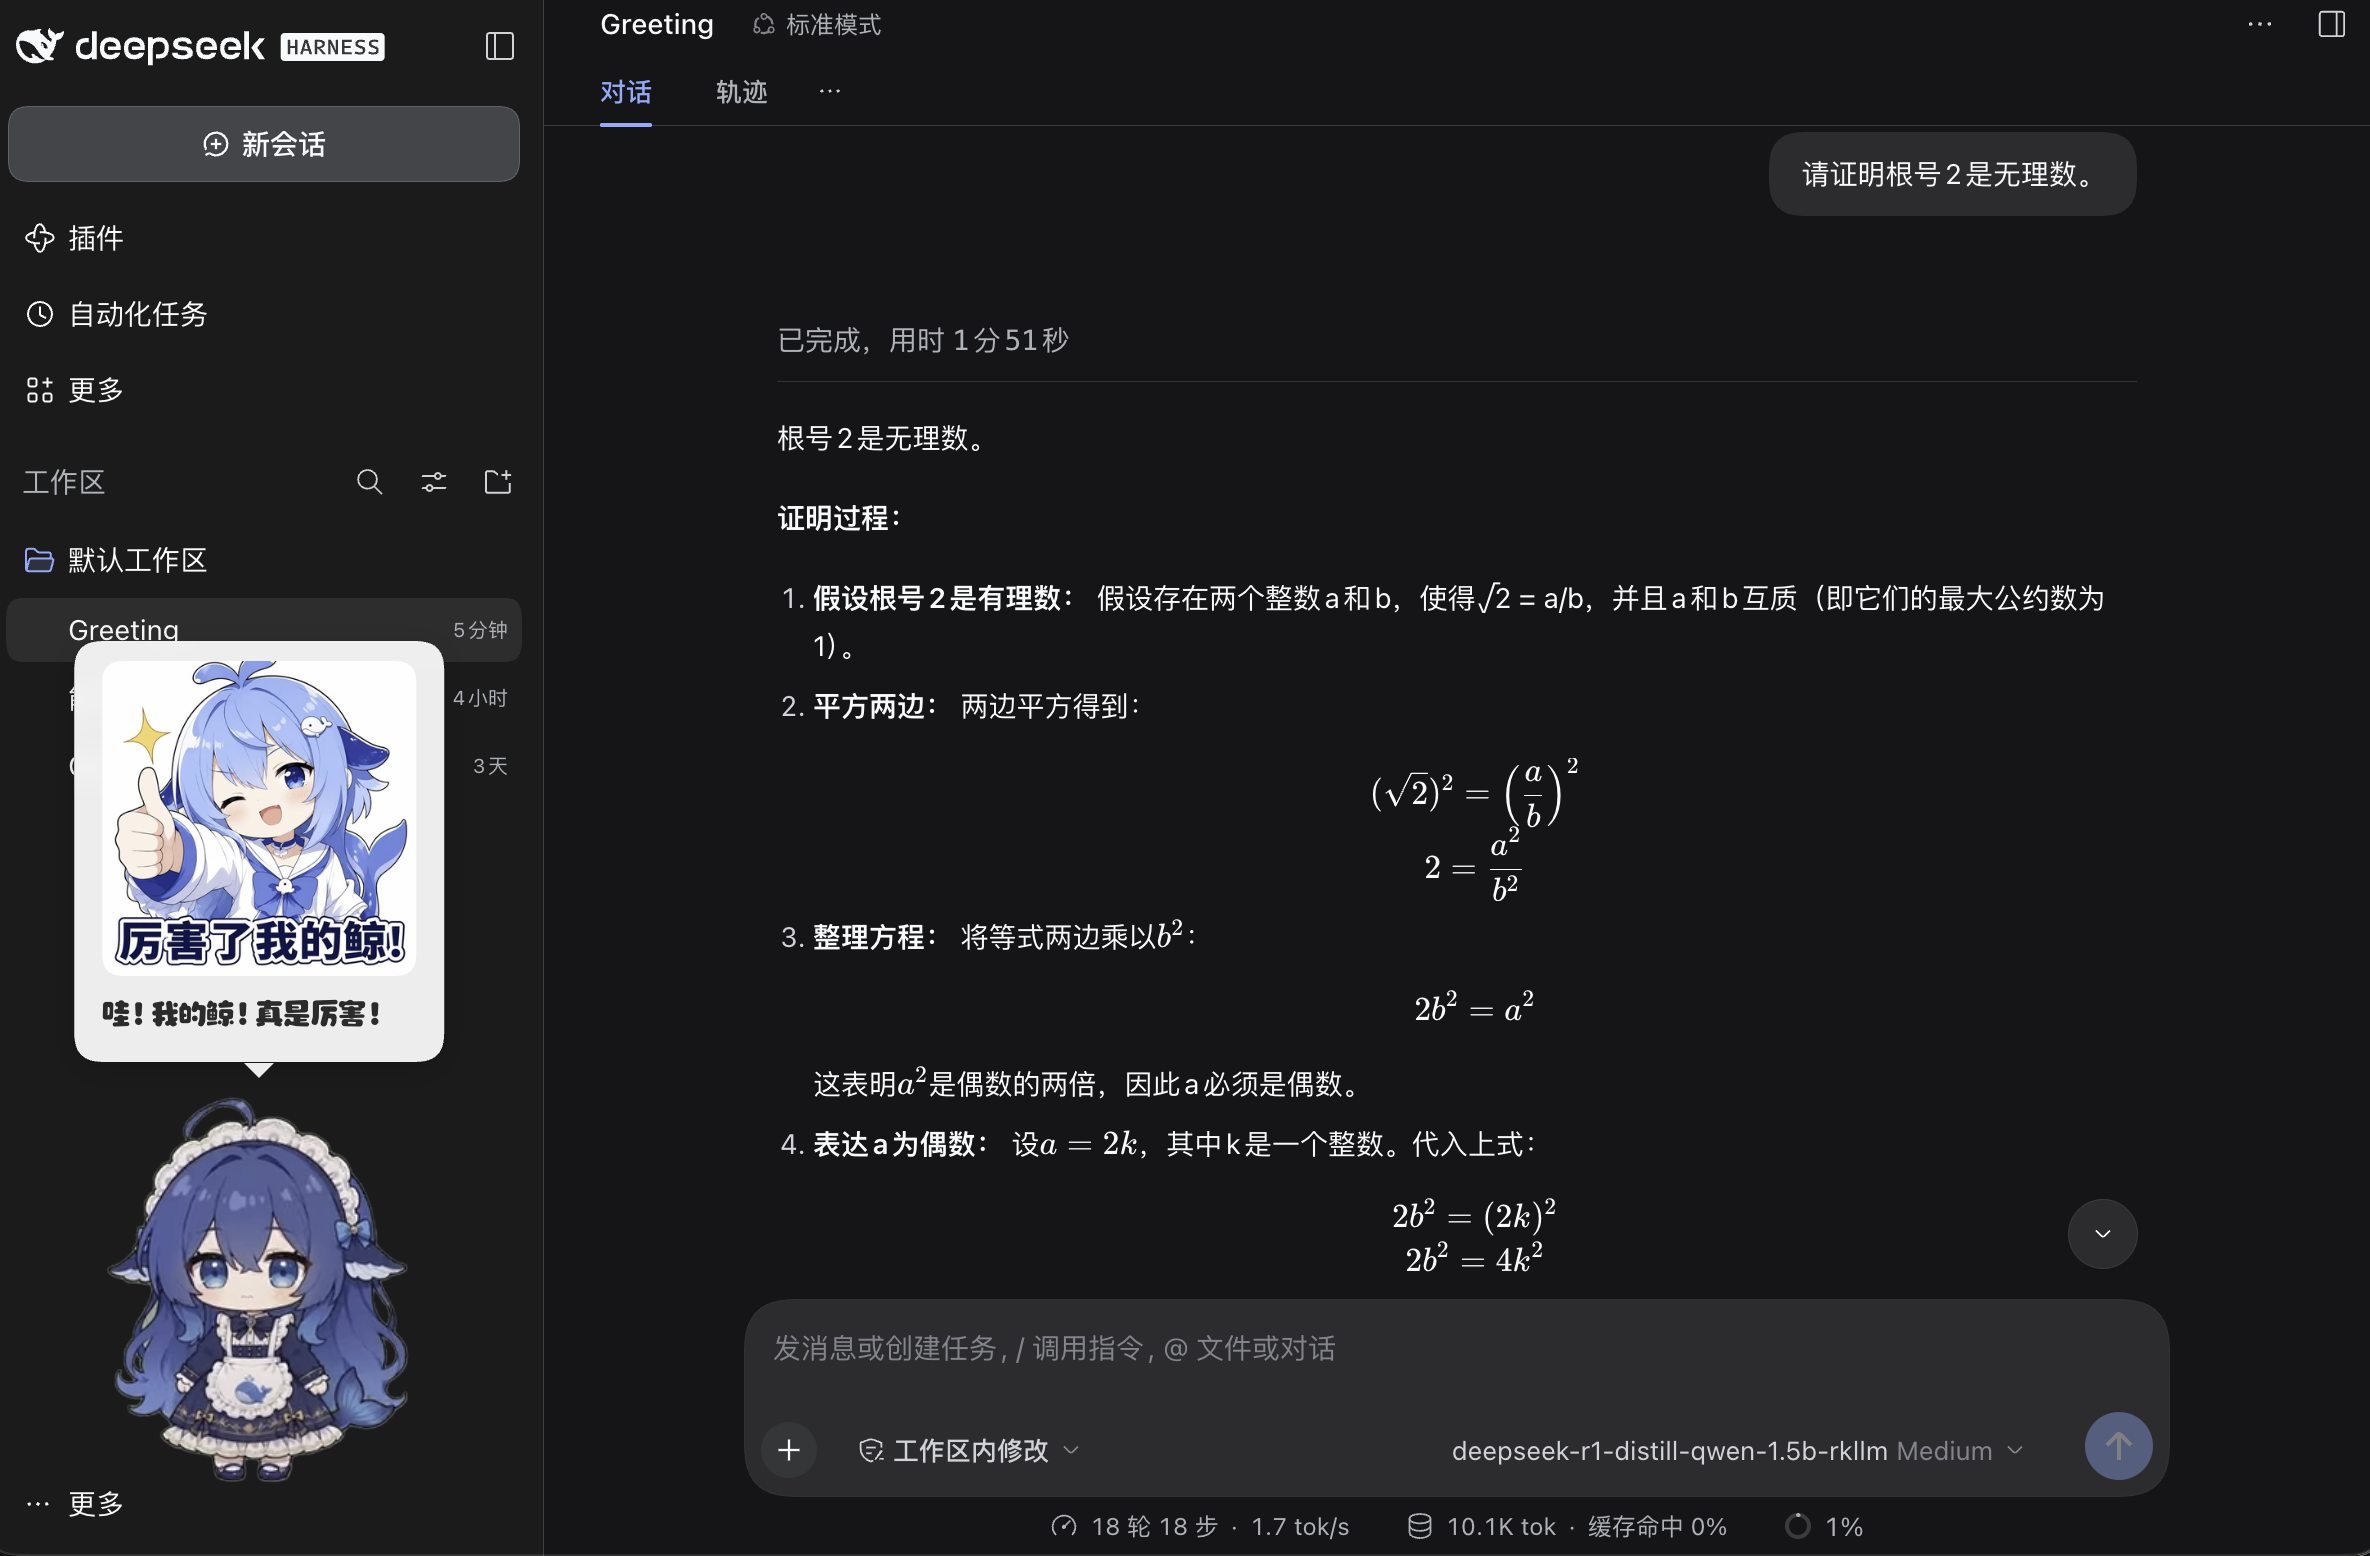
有一个档位对这个模型没有实际意义:off。DeepSeek-R1 蒸馏模型永远是先思考再回答,思考过程关不掉,所以 off 在服务端被当作和 low 一样处理,都是 512。
现在的状态与留下的经验
到这里,这条链路已经完整可用:
- DSH 在板上以 Web 方式运行(127.0.0.1:3080),靠随机 token 鉴权,token 通过日志上传网盘的方式取回
- 本地推理服务在 conda 的
rknn虚拟环境里运行(127.0.0.1:8080),对接 RKLLM 1.2.2 和 RK3588 的 NPU,模型是 DeepSeek-R1-Distill-Qwen-1.5B(W8A8),实测约 15.7 token/s、初始化约 2 秒、占用约 1.73GB 内存 - 接口带 Bearer API Key 验证,
/health免 key;验证脚本 17 项全过,覆盖鉴权、对话、流式、异常请求、并发和推理等级切换 - DSH 里通过
localllm提供方接入,上下文手动设为 4096,推理等级 low / medium / high 已真正生效 - 还没定的只有多模型切换方案:多进程多端口和单进程热切换两条路都已论证清楚,等确定要常驻哪几个模型再选
回头看,整个过程里最值得记下来的经验有这么几条:
- 版本要成套,不要混搭。 模型、demo、runtime 必须是同一代的东西。混用旧 demo 和新库,换了三个 runtime 版本都卡在同一行,最后换成成套的包一次就通。排查时逐个换版本是必要的,但要意识到“全都卡在同一行”本身就是指向公共部件的信号。
- 结构体绑定必须跟着头文件走。 C 接口用 ctypes 封装时,头文件里多两个字段,偏移一变,传进去的全是错位数据,表现只是干脆地返回 -1,没有任何提示。升级 runtime 后第一件事应该是逐字段核对结构体,而不是先怀疑模型。
- 文件完整性先于一切结论。 下载中途截断的库文件会造成 Bus error 这种误导性很强的现象。先核对大小和哈希,再谈版本结论,能省掉很多冤枉路。
git lfs那次报错也是同理:报错信息很吓人,但哈希一致就说明文件是好的。 - 推理模型的预算要按思考加正文算。 无论是云端的 Nemotron 还是本地的 DeepSeek-R1,都出现过 token 被思考耗尽、正文为空的情况。生成上限、空回复兜底,都要围绕这一点设计。
- 先写验证脚本,再说跑通了。 SSE 连接不关闭这种问题,在界面里随手聊一句是发现不了的。把鉴权、流式、异常输入、并发都写成可重跑的脚本,每改一处就全量回归,比任何口头确认都可靠。
- 进程和连接管理要守纪律。 按确切 PID 杀进程而不是宽匹配;SSH 频繁重试会触发出口限制,就定死冷却间隔、每次批量做完所有事;板子 IP 会跳变,连接前先确认地址。这些和模型无关的事,恰恰是远程调试一块开发板时最耗时间的部分。
本地小模型做 DSH 的对话后端已经够用,速度也在可接受范围内。至于让它稳定承担 agent 的工具调用、多模型之间自由切换,那是下一阶段的事了。
参考
- Radxa 官方文档(Rock 5B+ 与 RKLLM 相关页面):https://docs.radxa.com
- RKLLM 模型(ModelScope,radxa 发布):https://www.modelscope.cn/models/radxa/DeepSeek-R1-Distill-Qwen-1.5B_RKLLM
- rknn-llm 仓库与 RKLLM 头文件:https://github.com/airockchip/rknn-llm/blob/main/rkllm-runtime/Linux/librkllm_api/include/rkllm.h
- 官方 RKLLM Server 示例:https://github.com/airockchip/rknn-llm/tree/main/examples/rkllm_server_demo
- 本地模型桌宠插件 dsh-pet:https://github.com/PC2005-cloud/dsh-pet
- 前一篇:在 RK3588 上用 RKLLM 跑 DeepSeek 蒸馏模型(2025-06-24):https://blog.liuyc.uk/2025/06/24/rkllm-npu